사양 올려도 똑같이 버벅이는 워드프레스, 진짜 원인은 이것
집에 있는 시놀로지 NAS로 워드프레스를 연결해 쓰다 보면 언젠가부터 사이트가 답답하게 느껴지는 순간이 옵니다.
서버 사양을 높이거나 캐시 플러그인을 바꿔봐도 로딩 속도가 나아지지 않아 답답함을 겪는 분들이 많습니다.
끝까지 읽어보시면 서버 사양을 올리기 전에 먼저 확인해야 하는 실제 병목 원인을 파악하실 수 있습니다.
먼저 짧게 답부터 드리겠습니다. 사양을 올려도 그대로라면 자원이 모자란 게 아니라 요청이 처리되는 길목 어딘가가 막혀 있을 가능성이 큽니다. 자주 거론되는 후보는 PHP-FPM의 프로세스 수 설정, 겹쳐 도는 WP-Cron 작업, 느린 DB 쿼리나 특정 플러그인의 훅, 그리고 OPcache·페이지 캐시의 세부 설정입니다. 어느 쪽인지는 “어느 화면이 느린가”로 먼저 갈라 보면 됩니다.
아래 표는 증상별로 무엇을 의심하고 어디서 확인하는지 정리한 것입니다. 수치는 web.dev의 TTFB 문서가 제시하는 기준(0.8초 이하 좋음, 1.8초 초과 나쁨)을 바탕으로 한 예시이며, 환경마다 다를 수 있습니다.
| 증상 | 의심 원인 | 확인 도구 | 판단 기준(예시) |
|---|---|---|---|
| 관리자 화면과 글 저장이 느림 | 느린 DB 쿼리, 특정 플러그인의 훅, 외부 HTTP 호출 | Query Monitor | 쿼리 한 건이 수십 ms를 넘거나, 한 컴포넌트가 전체 시간의 대부분을 차지 |
| 접속자가 몰릴 때만 느려지고 대기가 생김 | PHP-FPM 프로세스 부족(pm.max_children) | PHP-FPM 로그, 상태 페이지, ps 명령 | 동시 처리 프로세스가 상한에 계속 붙어 있음 |
| 가끔 이유 없이 멈칫함 | WP-Cron 작업이 방문 요청에 실려 실행되거나 겹침 | wp cron event list | 밀린 이벤트가 쌓여 있거나 실행 시각이 몰려 있음 |
| 프론트만 느리고 관리자는 괜찮음 | 캐시 미적중, 무거운 스크립트 | GTmetrix, 브라우저 개발자 도구 | TTFB 0.8초 초과, 같은 URL을 두 번 열어도 TTFB가 줄지 않음 |
표의 첫 줄에 있는 “수십 ms”는 막연하게 읽힐 수 있어서 기준을 하나 붙여 둡니다. Query Monitor는 쿼리 한 건이 0.05초(50ms)를 넘으면 느린 쿼리로 표시하고, 이 값은 QM_DB_EXPENSIVE 상수로 바꿀 수 있습니다(Query Monitor 설정 상수 문서). 그래서 이 글에서는 50ms를 기본 기준으로 삼겠습니다. “한 컴포넌트가 대부분”은 공식 기준이 아니라 어디부터 볼지 정하려는 경험칙이고, 쿼리 시간 합계의 절반 이상을 한 플러그인이 차지하면 그쪽을 먼저 의심해 보시면 됩니다.
테스트 환경 및 수정일(예시): 시놀로지 NAS(4 vCPU, 8GB 램 가정), DSM 7.x, PHP 8.x, 워드프레스 6.x 기준으로 정리했으며 최종 수정일은 2026년 10월입니다. 실제 환경에서는 버전에 따라 메뉴와 설정 이름이 다를 수 있습니다.
이 글에서 인용한 PHP 매뉴얼과 Query Monitor 문서는 2026년 10월 25일에 다시 열어 확인했습니다. 글 안의 계산 값과 표의 수치는 이해를 돕기 위한 예시이고, 제 사이트에서 직접 잰 결과가 아닙니다.
서버 사양을 높여도 속도가 그대로인 이유

워드프레스 속도가 느려지면 가장 먼저 서버 메모리를 늘리거나 CPU 사양을 업그레이드하는 방법을 떠올리게 됩니다.
하지만 4 vCPU와 8GB 램 환경에서도 관리자 화면이 굼뜨거나 글 저장이 한참 걸리는 현상이 발생하곤 합니다.
서버의 물리적인 자원이 충분한 상태인데도 사이트가 버벅인다면 리소스 부족 외에 다른 문제가 숨어있다는 뜻입니다.
단순히 하드웨어 성능만 믿고 사양을 올리려 했다면 비용만 쓰고 실망하기 쉽습니다.
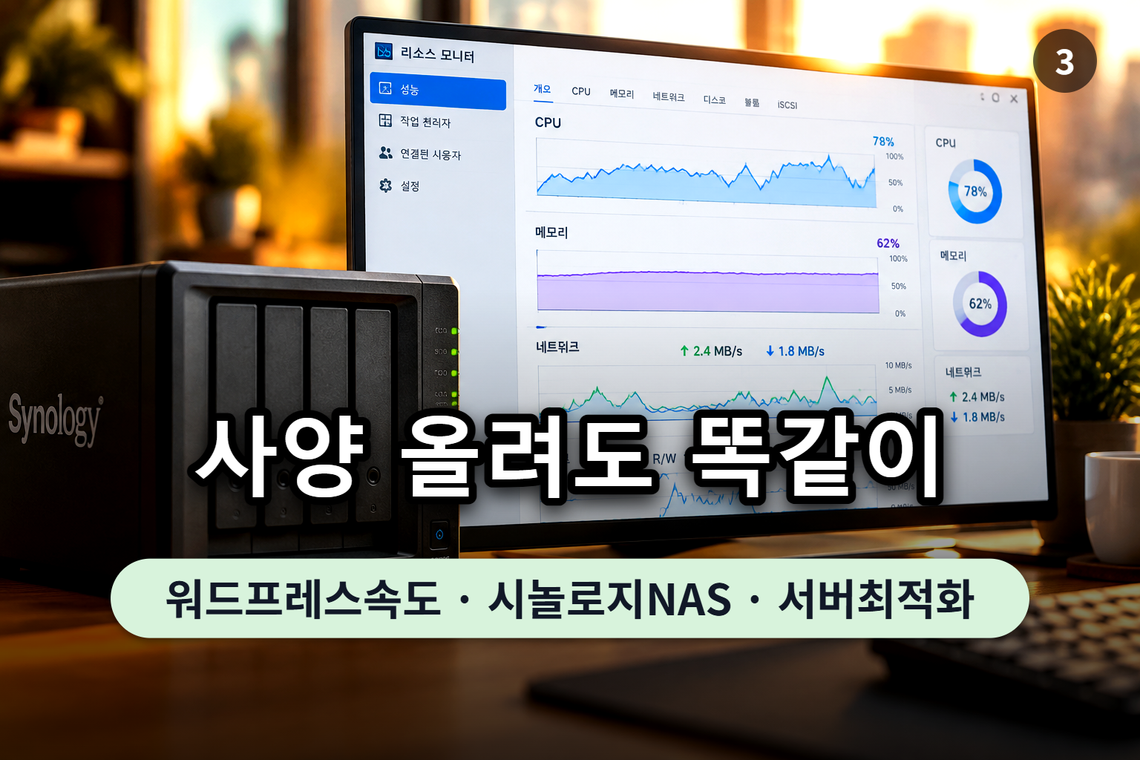
위 캡처처럼 느린 순간에 리소스 모니터를 같이 띄워 보면 판단이 쉬워집니다. CPU와 메모리가 한가한데도 느리다면 증설은 효과가 없고, 반대로 CPU가 계속 꽉 차 있다면 증설이 도움이 될 수 있습니다. 사양 증설이 통하는 경우와 안 통하는 경우를 나눠 보면 다음과 같습니다.
| 구분 | 증설이 효과 있는 경우 | 증설이 효과 없는 경우 |
|---|---|---|
| 리소스 모니터 | CPU나 메모리 사용률이 높게 유지되고 스왑이 발생 | 느린 순간에도 CPU·메모리에 여유가 있음 |
| PHP-FPM | 프로세스를 늘릴 메모리가 부족해 상한을 올리지 못함 | 메모리는 남는데 pm.max_children이 낮게 묶여 있음 |
| DB 쿼리 | DB 버퍼가 부족해 디스크를 자주 읽음 | 인덱스 없는 쿼리나 특정 플러그인의 반복 쿼리가 원인 |
| NAS 특성 | 저장소 I/O 대기가 낮은데 연산이 모자란 경우 | HDD·네트워크 스토리지의 I/O 대기, 리버스 프록시나 컨테이너 설정이 병목인 경우 |
표의 마지막 줄은 NAS에서 특히 자주 놓치는 부분이라 확인 방법을 풀어 둡니다. 어느 쪽이든 사이트가 느린 순간에 같이 봐야 의미가 있습니다.
- 저장소 I/O 대기: SSH에서
top을 열면 맨 위 CPU 줄에wa값이 보입니다. CPU가 디스크 응답을 기다리며 쉬고 있는 비율이라서, 사이트가 느린 순간에 이 값이 계속 높다면 사양이 아니라 저장소가 병목이라는 신호입니다. 콘솔 대신 DSM의 리소스 모니터에서 성능 항목의 디스크·볼륨 사용률을 같은 시간대에 함께 볼 수도 있습니다. 메뉴 이름은 DSM 버전에 따라 조금 다를 수 있습니다. 다만 볼륨 사용률이 높게 나온다고 곧 문제가 있다는 뜻은 아닙니다. 시놀로지 커뮤니티 안내에서는 이 값이 해당 시간 동안 I/O가 볼륨을 점유한 비율을 보여 줄 뿐이라고 설명합니다(시놀로지 커뮤니티 질문). 그러니 이 값 하나로 결론 내지 말고wa나 실제 TTFB와 겹쳐 봐야 합니다. - 리버스 프록시: DSM 리버스 프록시를 거치는 주소와 NAS 내부 포트로 바로 접속한 주소에서 같은 페이지의 TTFB를 비교해 보세요. 직접 접속은 빠르고 프록시를 거치면 느리다면, PHP와 DB가 아니라 프록시 구간을 손봐야 합니다.
- 컨테이너: Docker로 워드프레스를 돌린다면 SSH에서
docker stats로 컨테이너별 CPU·메모리 사용량과 제한값을 봅니다. 컨테이너에 메모리나 CPU 제한이 걸려 있으면 NAS 전체에는 여유가 있어도 워드프레스 컨테이너만 한계에 붙을 수 있습니다. 이 경우 NAS 램을 늘려도 소용이 없습니다.
실제 병목을 만드는 숨은 원인과 진단

속도 저하의 진짜 원인을 찾으려면 무작정 플러그인을 추가하거나 캐시를 비우는 행동은 피해야 합니다.
오히려 최적화 플러그인을 이것저것 설치했다가 사이트 성능이 더 떨어지는 사례를 종종 보게 됩니다.
정확한 진단을 위해서는 GTmetrix나 Query Monitor 같은 도구를 활용해 어디서 지연이 생기는지 범위를 좁혀야 합니다.
특히 SSH를 통해 서버에 직접 접속해 보면 PHP-FPM 설정 문제나 백그라운드 크론 작업의 중첩이 원인으로 드러나는 경우가 있습니다.
범위를 좁히는 순서는 이렇습니다. 어디가 느린지부터 나눠야 엉뚱한 곳을 손보지 않습니다.
- 느린 화면 정하기: 관리자 화면이 느린지, 방문자가 보는 프론트만 느린지 먼저 정합니다. 관리자만 느리면 캐시가 아니라 PHP와 DB 쪽이라는 뜻입니다. 방문자용 페이지 캐시는 관리자 화면에 적용되지 않는 경우가 많기 때문입니다.
- TTFB 확인: GTmetrix 결과나 브라우저 개발자 도구의 Network 탭에서 문서 요청의 TTFB를 봅니다. web.dev는 0.8초 이하를 좋은 수준으로, 1.8초를 넘으면 나쁜 수준으로 봅니다. TTFB가 이 기준을 넘으면 서버 처리 시간이 길다는 뜻이므로 아래 단계로 내려갑니다.
- Query Monitor 보기: 플러그인을 설치하면 관리 툴바에 현재 페이지 개요가 나타납니다. 메뉴에서 쿼리 패널로 들어가 느린 쿼리와 중복 쿼리, 쿼리를 일으킨 플러그인·테마 단위 집계를 봅니다. 훅과 HTTP API 호출 패널에서는 응답 코드와 소요 시간도 확인할 수 있습니다. 외부 서버 호출이 오래 걸리면 사양과 상관없이 페이지가 같이 멈춥니다. 자세한 기능은 Query Monitor 플러그인 페이지에 있습니다.
- PHP-FPM 상태 확인: SSH로 접속해 FPM 프로세스 수와 로그를 봅니다. 아래에서 자세히 설명합니다.
- WP-Cron 확인: 예약 작업이 몰리거나 밀려 있는지 봅니다. 이것도 아래에서 이어서 설명합니다.
3번의 Query Monitor는 화면에서 이렇게 보면 빠릅니다. 느린 화면(예: 글 편집 화면)을 연 상태에서 툴바의 Query Monitor 메뉴를 열고 아래 순서로 따라가 보세요.
- 툴바 개요에서 전체 페이지 생성 시간과 쿼리 수, 쿼리 총 시간을 먼저 봅니다. 쿼리 총 시간이 전체의 절반도 안 되면 DB보다 PHP 실행이나 외부 호출 쪽이 더 의심스럽습니다.
- 쿼리 패널에서 소요 시간 열을 기준으로 정렬하고, 위쪽 몇 건이 50ms(앞서 말한 기본 기준)를 넘는지 확인합니다. 열 머리글 이름은 버전에 따라 조금 다를 수 있습니다.
- 컴포넌트별 집계 화면에서 어느 플러그인이나 테마가 시간을 가장 많이 쓰는지 봅니다. 한 컴포넌트가 쿼리 시간의 절반 이상이면 그 플러그인을 끄고 같은 화면을 다시 열어 비교합니다.
- HTTP API 호출 패널에서 응답이 오래 걸리거나 실패하는 외부 호출이 있는지 봅니다. 이런 호출은 DB 쿼리가 빨라도 페이지를 멈추게 합니다.
PHP-FPM은 요청을 처리할 자식 프로세스를 몇 개 둘지 설정으로 정합니다. PHP 매뉴얼에 따르면 pm은 프로세스 관리 방식(static, ondemand, dynamic)이고, pm.max_children은 동시에 처리할 수 있는 요청 수의 상한입니다. 이 값이 낮으면 CPU와 램이 남아도 요청이 줄을 서서 기다리게 됩니다. 사양을 올려도 그대로인 이유가 여기에 있는 경우가 있습니다.
SSH로 접속해서는 다음 정도를 봅니다. 설정 파일 위치는 NAS와 패키지 구성마다 달라서, php-fpm -tt로 읽어 들이는 설정 파일을 찾거나 find / -name "www.conf" 2>/dev/null로 찾아보는 편이 확실합니다.
ps -ef | grep php-fpm | wc -l: 지금 떠 있는 FPM 프로세스 수를 대략 셉니다. 이 명령은 grep 자신과 마스터 프로세스도 함께 세므로 실제 워커 수보다 보통 2개 많게 나옵니다. 느린 순간마다 이 수가pm.max_children값에 붙어 있다면 상한이 병목일 수 있습니다. 이때 FPM 로그에 max_children 상한에 도달했다는 경고가 남기도 합니다.top: 프로세스별 CPU와 메모리 사용량을 봅니다. php-fpm 프로세스 하나가 메모리를 얼마나 쓰는지 알아야pm.max_children을 램 안에서 몇 개까지 올릴 수 있는지 계산할 수 있습니다.request_slowlog_timeout = 5s와slowlog경로를 설정하면, 5초를 넘긴 요청의 PHP 백트레이스가 로그에 남습니다. 기본값은 0이라 꺼져 있습니다. 어떤 플러그인 함수에서 오래 걸리는지 이 로그로 확인할 수 있습니다.pm.status_path = /status를 설정하면 상태 페이지로 프로세스 현황을 볼 수 있습니다. 다만 외부에 노출되지 않도록 접근 제한을 같이 걸어야 합니다.
위 목록의 처음 두 항목은 조금 더 정확하게 볼 수 있습니다. 마스터와 grep을 빼고 워커만 세려면 아래처럼 하면 됩니다. 워커의 프로세스 이름은 보통 php-fpm: pool 풀이름 형태이고, 대괄호는 grep이 자기 자신을 세지 않게 하는 방법입니다. 이름은 PHP 버전과 패키지에 따라 다를 수 있습니다.
# 워커 수 (마스터, grep 제외)
ps -eo cmd | grep -c '[p]hp-fpm: pool'

# 워커별 메모리(RSS, KB 단위)
ps -eo pid,rss,cmd | grep '[p]hp-fpm: pool'
상태 페이지를 켜 두면 세어 볼 필요도 줄어듭니다. PHP 매뉴얼의 상태 페이지 문서 기준으로, 아래 항목만 보셔도 상한이 병목인지 판단할 수 있습니다. 모든 값은 FPM을 재시작하면 0부터 다시 쌓입니다.
| 상태 페이지 항목 | 의미 | 이렇게 읽습니다 |
|---|---|---|
| listen queue | 빈 프로세스를 기다리는 요청 수 | 0이 아니고 idle processes도 0이면 줄을 서고 있다는 뜻입니다 |
| max children reached | 프로세스 상한에 닿은 적이 있는지 | 1 이상이면 닿은 적이 있습니다. 재시작 뒤에도 계속 늘면 상한이 낮거나 요청이 느린 것입니다 |
| active / max active processes | 지금 일하는 수 / 최대로 동시에 일한 수 | max active가 pm.max_children과 같다면 상한까지 찼던 적이 있습니다 |
| slow requests | request_slowlog_timeout을 넘긴 요청 수 | 늘고 있다면 slowlog에서 어떤 함수가 오래 걸리는지 봅니다 |
상태 페이지에는 요청 주소 같은 정보가 나오니, 웹 서버 설정에서 로컬이나 내가 아는 IP만 접근하게 막아 두세요. PHP 8.0 이상이라면 pm.status_listen으로 상태 페이지만 별도 주소로 열어 두는 방법도 있습니다. 요청이 밀려 풀이 가득 찬 순간에도 상태 페이지가 열려서 편합니다.
이제 pm.max_children을 얼마로 잡을지입니다. 기준은 단순해서, 워커 하나가 쓰는 메모리에 워커 수를 곱한 값이 PHP에 쓸 수 있는 램을 넘지 않아야 합니다. 워커 메모리는 위 ps 결과의 RSS(KB 단위)를 여러 개 보고 평균을 냅니다. RSS에는 워커끼리 공유하는 메모리도 중복해서 들어가 있어서 실제보다 크게 잡히는 편이고, 그만큼 안전한 쪽의 계산입니다.
| 단계 | 계산(예시) |
|---|---|
| NAS 전체 램 | 8GB (8192MB) |
| DSM, DB, 다른 패키지가 쓰는 램(가정) | 약 3GB (3072MB) |
| PHP-FPM에 쓸 수 있는 램 | 8192 − 3072 = 5120MB |
| 워커 하나의 평균 RSS(가정) | 약 60MB |
| 이론상 상한 | 5120 ÷ 60 ≈ 85 |
| 여유를 두고 정한 값 | 70 안팎에서 시작 |
이 값은 계산상의 천장이고, 처음부터 천장까지 올릴 필요는 없습니다. 사용자가 몇 명 되지 않는 개인 사이트라면 훨씬 낮은 값으로도 충분한 경우가 많습니다. 현재 값보다 조금만 올려 보고 아래 순서로 적용하세요.
- 1번에서 찾은 풀 설정 파일(예:
www.conf)을 백업한 뒤, 해당 풀 섹션의pm.max_children값을 수정합니다.pm = dynamic이라면pm.start_servers,pm.min_spare_servers,pm.max_spare_servers가 max_children보다 크지 않은지도 같이 봅니다. php-fpm -t로 설정 문법을 검사합니다. 바이너리 이름은php-fpm8.x처럼 버전이 붙어 있을 수 있습니다.- FPM 서비스를 reload하거나 재시작합니다. 시놀로지는 패키지 구성에 따라 방법이 다릅니다. DSM의 패키지 센터에서 해당 패키지를 중지·실행하거나, SSH에서 서비스 관리 명령을 쓰는 식이며 환경마다 다를 수 있습니다. 가능하면 진행 중인 요청을 끝내고 설정을 반영하는 reload를 먼저 쓰세요.
- 상태 페이지의
max children reached가 재시작 뒤 0에서 늘지 않는지, 느린 순간에top이나 리소스 모니터에서 메모리와 스왑이 버티는지 몇 시간에서 하루 정도 지켜봅니다. 스왑이 생기기 시작하면 올린 값이 너무 큰 것이니 한 단계 낮추세요.
크론 쪽은 원리를 알면 이해가 쉽습니다. 워드프레스 개발자 문서에 따르면 WP-Cron은 상시 도는 스케줄러가 아니라 페이지가 로드될 때 예약 목록을 확인하고, 시간이 된 작업을 그 요청 중에 실행합니다. 그래서 무거운 작업이 하필 방문자나 내가 글을 저장하는 요청에 얹히면 그 요청이 느려질 수 있습니다. 예약 작업이 많은 사이트에서는 이 작업들이 한꺼번에 몰리기도 합니다.
wp cron event list: WP-CLI로 예약된 이벤트의 훅 이름, 다음 실행 시각, 반복 주기를 봅니다(명령 문서). 같은 시각에 이벤트가 몰려 있거나 실행 시각이 한참 지났는데 남아 있는 이벤트가 많다면 의심해 볼 만합니다.- 대안으로
wp-config.php에define( 'DISABLE_WP_CRON', true );를 넣어 방문 요청마다 도는 방식을 끄고, 시스템 크론이 주기적으로wp-cron.php를 호출하게 할 수 있습니다. 방법은 공식 문서에 있습니다. 이렇게 하면 작업이 방문자 요청과 분리되지만, 시스템 크론을 제대로 등록하지 않으면 예약 글 발행도 멈추므로 꼭 함께 설정해야 합니다.
램 증설보다 진단 도구가 먼저인 이유

결국 워드프레스 속도 개선의 핵심은 무조건적인 장비 업그레이드가 아니라 정확한 병목 구간 파악에 있습니다.
OPcache나 페이지 캐시가 이미 적용되어 있더라도 세부 설정에 구멍이 있으면 사이트는 여전히 느리게 작동합니다.
이번에 자료를 찾아보면서 램을 무리하게 늘리기 전에 진단 도구로 PHP 연산과 DB 쿼리를 먼저 점검하는 게 순서라는 점을 알게 됐습니다.
제한된 리소스를 쓰는 환경일수록 불필요한 스크립트와 백그라운드 작업을 정리하는 편이 훨씬 효과적입니다.
“세부 설정에 구멍”이라고 한 부분은 구체적으로 이런 항목들입니다. PHP 매뉴얼의 OPcache 설정 기준으로 정리했습니다.
opcache.memory_consumption: OPcache 공유 메모리 크기이며 기본값은 128MB입니다. 플러그인이 많아 스크립트가 이 공간에 다 들어가지 못하면 캐시가 계속 밀려나 효과가 줄어듭니다.opcache.max_accelerated_files: 캐시할 수 있는 스크립트 수의 상한이며 기본값은 10000입니다. 워드프레스 코어에 플러그인과 테마 파일까지 더하면 이 상한에 가까워질 수 있습니다.opcache.validate_timestamps와opcache.revalidate_freq: 파일 변경 여부를 확인하는 방식과 주기입니다. 기본은 2초마다 확인합니다. 운영 환경에서 끄면 확인 부담은 줄지만, 플러그인을 업데이트한 뒤 캐시를 비우거나 PHP-FPM을 재시작해야 반영됩니다.- 페이지 캐시 쪽은 캐시 제외 규칙과 로그인 사용자 캐시 우회 설정을 봅니다. 제외 규칙이 너무 넓으면 대부분의 페이지가 캐시를 타지 못합니다. 로그인한 상태로 점검하면 캐시가 적용되지 않는 것이 정상이므로, 시크릿 창에서 같은 URL을 두 번 열어 TTFB가 줄어드는지 비교해야 합니다.
PHP 명령줄(CLI)과 웹에서 도는 PHP-FPM은 설정이 다를 수 있어서, 터미널의 php -i 결과만 믿지 말고 웹에서 실제로 적용된 값을 확인하는 편이 안전합니다. 이미지 쪽도 의심된다면 이미지 최적화 후 느릴 때 확인하는 방법을, 플러그인이 의심된다면 워드프레스 플러그인 몇 개가 적당한지보다 중요한 것을 함께 보시면 됩니다.
설정을 바꾼 뒤에는 반드시 같은 조건으로 다시 재야 효과를 알 수 있습니다. 같은 URL, 같은 로그인 상태, 같은 시간대에 세 번 정도 측정해서 중앙값을 비교하세요. 아래는 기록 방식의 예시입니다.
| 항목 | 변경 전 | 변경 후 |
|---|---|---|
| 프론트 TTFB(시크릿 창, 캐시 적중 후) | 1.2초 | 0.5초 |
| 관리자 글 저장 시간 | 6초 | 2초 |
| Query Monitor 가장 느린 쿼리 | 180ms | 25ms |
| 느린 순간의 php-fpm 프로세스 수 | 상한에 도달 | 상한 아래 |
표의 값은 이해를 돕기 위한 예시일 뿐입니다. 독자님의 사이트에서는 같은 항목을 같은 방식으로 적어 두고, 바꾼 항목이 하나뿐일 때의 변화를 보세요. 변경 후 Query Monitor의 가장 느린 쿼리가 50ms 아래로 내려왔는지, 상태 페이지의 max children reached가 더 늘지 않는지가 변경이 먹혔는지 가리는 가장 분명한 신호입니다.
서버 사양을 무작정 올리기 전에 설정과 백그라운드 작업을 먼저 점검해 보는 편이 실질적인 해결책이 됩니다. 위 표의 증상부터 하나씩 대조해 보시고, 한 번에 하나씩만 바꿔서 변화를 확인하세요.
이 글은 워드프레스 속도 점검의 출발점이라서, 원인이 서버 설정이 아니라 다른 쪽으로 좁혀졌다면 아래 글로 이어서 가시면 됩니다. 순서는 관리자 화면 → 플러그인 → 테마 → 캐시 → 이미지 순으로 읽으시길 권합니다.


You May Also Like
워드프레스 모바일 LCP 느리게 나올 때 캐시 설정 확인하는 법
AI 브리핑이 먼저 선택하는 블로그 글쓰기 비법